后空翻好看,但能拧螺丝吗?拆解具身智能量产前夜最致命的“物理数据饥渴”
2026年11月1日 · 来源:稳点科技观察 · 作者:稳点科技观察编辑部
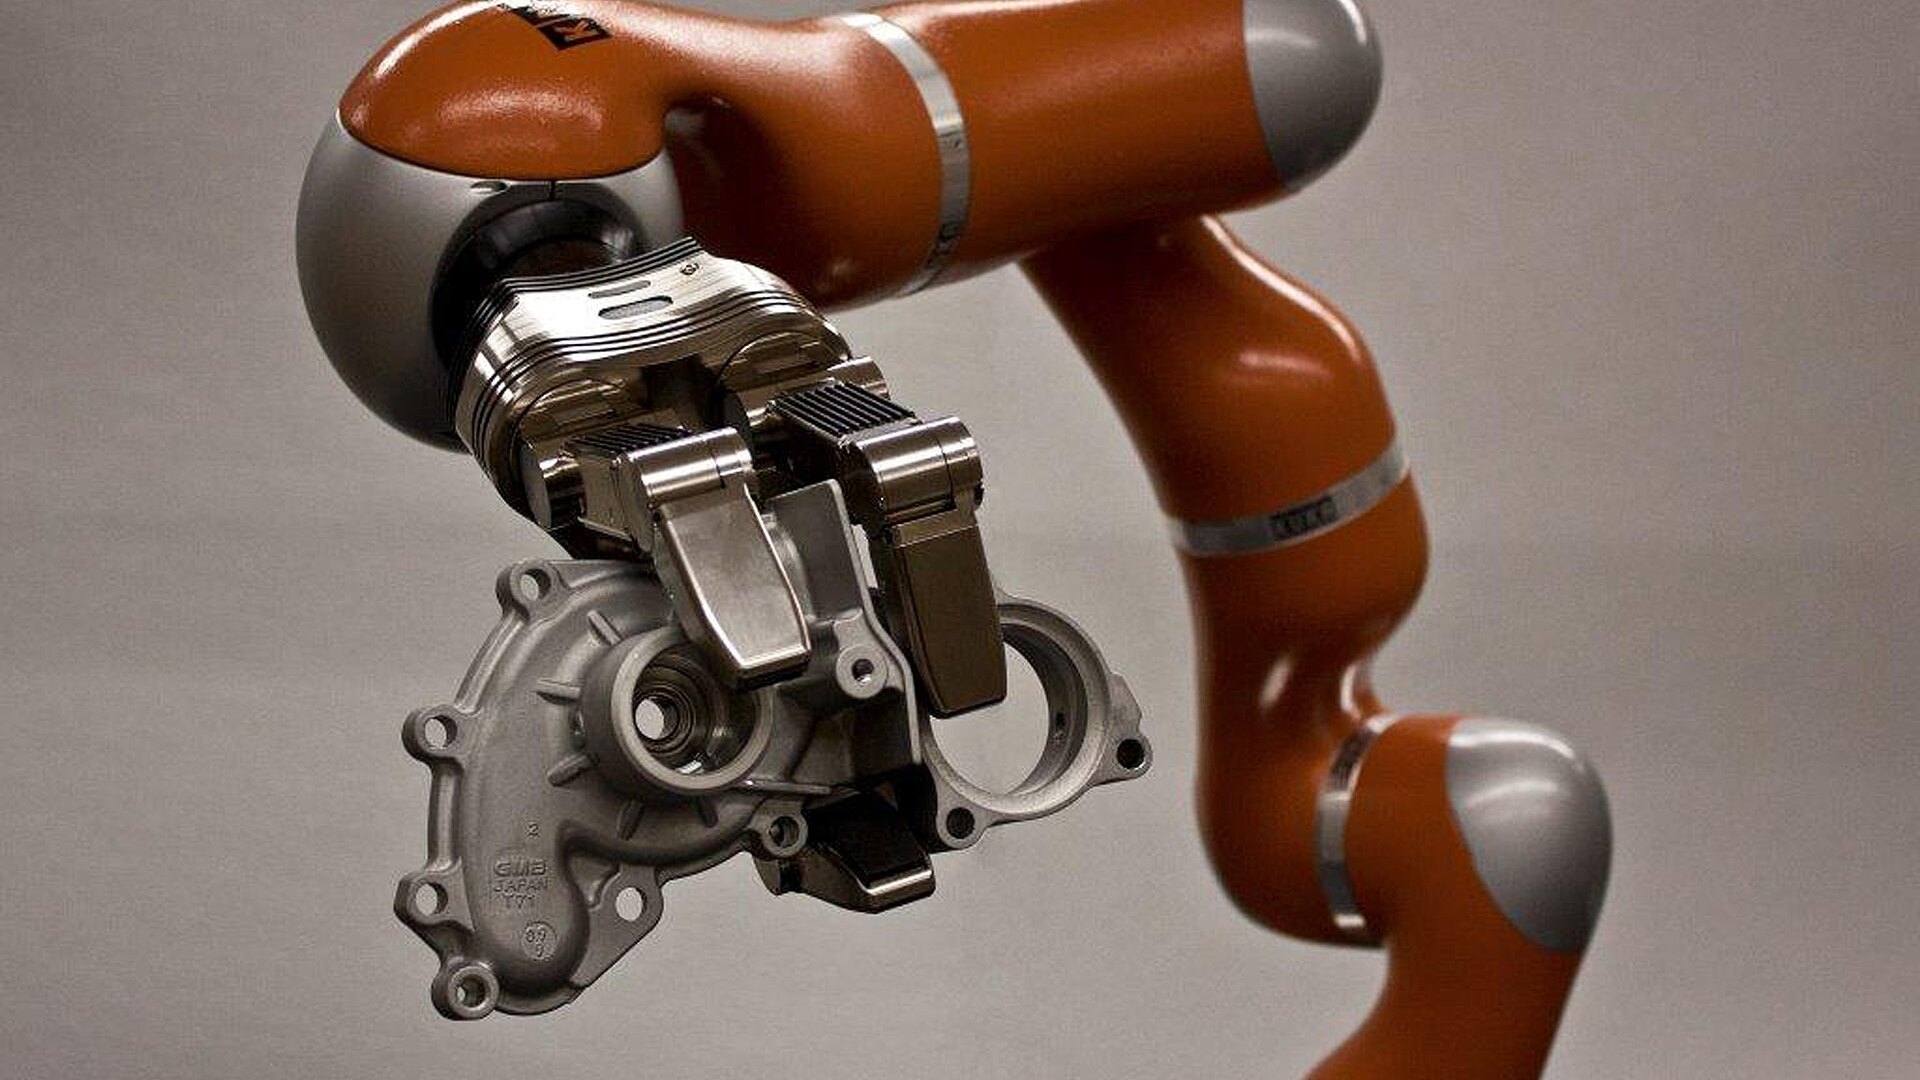
先放两段画面。
第一段,2024 年 3 月 20 日,宇树发布 H1。H1 站在原地,向后翻了一个跟头,稳稳落地。宇树称,这是第一台不靠液压、纯电机驱动的全尺寸人形机器人后空翻。波士顿动力的 Atlas 2017 年就翻过,那一台是液压的。近两年后,宇树又陆续放出 H2 的飞踢、空翻训练视频,以及 2026 年 8 月那段 30 秒的“超人”演示:原地跳高 2 米,奔跑速度 12.66 米/秒(据媒体报道,均为公司发布的演示)。
第二段没人专门拍。美国南卡罗来纳州的宝马工厂里,一台 Figure 02 从料框里拿起一块钣金件,放进焊接夹具。放准了,下一块。
哪个更难?外行说第一个,做机器人的多半说第二个。
身体的事,和手上的事
后空翻面对的是一块平整、已知的地面。动作固定,变量少,可以一遍遍练。难处在力矩、时序和平衡,这些都能写进物理模型里去算。算得准,练得够,就翻得过去。
拧一颗螺丝不一样。眼睛得先找到孔,螺丝刀对准,偏几毫米就滑;螺纹咬上的那一下,靠的是手上的力感;扭矩到了得停;碰到滑牙、孔偏、工件上沾了油,还得换个办法。这些没法在纸面上算清楚,得在真机上一次次碰出来。
宝马那个工位给了几个具体的数:钣金件放进夹具,误差要在 5 毫米以内;一个循环 84 秒,上料占 37 秒;目标是放置准确率 99% 以上(据 Figure 公布的信息,Humanoids Daily 报道)。
99% 为什么这么要紧?因为活是一串步骤,成功率要连乘。
| 每一步成功率 | 连续 1 步 | 连续 5 步 | 连续 10 步 | 连续 20 步 |
|---|---|---|---|---|
| 99% | 99.0% | 95.1% | 90.4% | 81.8% |
| 95% | 95.0% | 77.4% | 59.9% | 35.8% |
| 90% | 90.0% | 59.0% | 34.9% | 12.2% |
(编辑部按连乘计算,假设各步相互独立。)
演示视频里,90% 已经很好看了。可一个十步的装配流程,每步 90%,整串只剩 35%,三件里有两件得叫人来补。车间要的是第一行,不是第三行。
要把 90% 推到 99%,办法只有一个:让机器见过足够多次的“碰”。
数据到底差多少
先摆几个公开的数。
| 数据集 | 规模 | 备注 |
|---|---|---|
| DROID | 7.6 万条演示,约 350 小时 | 564 个场景、86 个任务,同一种机械臂(Franka) |
| Open X-Embodiment | 超过 100 万条轨迹 | 22 种机器人、500 多项技能,21 家机构合作,2023 年发布 |
| AgiBot World | 超过 100 万条轨迹 | 217 个任务、5 类场景,智元 2025 年 3 月发布 |
| Generalist 的 GEN-0 | 超过 27 万小时真实操作数据,每周新增约 1 万小时 | 公司自有数据集,2025 年 11 月随 GEN-0 模型披露 |
350 小时,不到 15 天。Meta 的 Llama 3 405B,训练用了 15.6 万亿个文字 token。单位不同,没法直接相除,摆在一起,差距明摆着。
再看整个行业。中国信通院《具身智能训练场研究报告(2026 年)》的判断是,机器人要等到自己的“ChatGPT 时刻”,至少需要千万小时级的有效数据,而全球可用的高质量真实数据,大约在数十万到百万小时。澎湃新闻 2026 年 4 月的文章给的数更具体:约 50 万小时,不足大语言模型训练数据的两万分之一。口径各家不同,量级是一致的:缺口在二十倍以上,而且这还是在“任务越多越好”的假设下。
有个对照值得放在这里。Generalist 一家公司称自己的真实操作数据已经超过 27 万小时,每周还增加 1 万小时。如果两个数都靠谱,一家公司手里的量,就达到了全行业“高质量真实数据”估算值的一半以上。编辑部不认为这两个数可以直接相减,它们出自不同的统计口径,Generalist 的数据也没有公开。但它说明了另一件事:数据做到极大规模,是有人在做的,只是做这件事的人,不太愿意把数据放出来。
这些数据里,不少还是“把东西从 A 放到 B”“叠衣服”“收桌子”,离“对准螺纹、拧到扭矩”有一段距离。Physical Intelligence 在 2024 年 10 月发布的 π0,叠衣服、收桌子、装箱都能做,叠衬衫得分满分,杂货装袋 0.786,从烤面包机里取吐司 0.75,这些都是自己实验环境里的结果,作者自己也写,这只是“很小的早期一步”,通用机器人策略“还在婴儿期”。智元的 GO-1,论文称复杂任务成功率超过 60%,同样是公司自己的测试。60% 对车间要的 99%,错误率差了几十倍。
换个角度看,可以算一笔每个任务的账。21 财经报道里的业内人士给过一组经验值:分拣螺丝这类简单任务,需要十几到二十小时的数据,成功率能到 90% 以上;整车环视这样的复杂任务,需要数百小时,才能支撑成功率超过 90%。真机遥操作的数据,市场报价每小时 500 到 1000 元(另有口径是 200 到 500 元)。编辑部按这个价格粗算:一个简单任务,十几二十小时,约 0.5 万到 2 万元;一个复杂任务,三百小时,约 15 万到 30 万元。单看一个工位,数据并不贵。
贵在每个工位都要来一遍。今天学会放钣金,明天换成插线束,后天换成拧另一种螺丝,数据又得重攒。工厂的活是长尾,数据也是长尾。
补数据也不是找来一个数据集就行。每家机器人的关节、相机位置、手的形状都不一样,数据很难通用。Open X-Embodiment 的价值,是证明了跨机型的数据确实管用:DeepMind 称,用这套数据训练的模型,在五台机器人上的平均成功率,比各自原来的模型高 50%。可它同时暴露了麻烦:数据格式、视角、任务拆法都不统一,拼起来费劲。
海外的做法,和国内不太一样。他们更像是把机器人当成采集数据的探头,先把机器送到愿意收的人手里。波士顿动力的 Atlas,就是开头那台翻过跟头的机器的后代,据报道 2026 年的订单已经全部订满,首批发货给现代汽车的机器人应用中心和谷歌 DeepMind,2027 年初才增加客户。把杂技演员送到做模型的公司手里,要的显然不是它的后空翻。特斯拉的 Optimus,周产量据报道已经从二季度的几十台提到几百台,年底的目标是每周 1000 台以上,但 IDC 的统计里,它目前主要用于内部测试。这些机器干的第一件事,是产生数据,不是产生产值。
仿真能批量造数据,这是真的。英伟达称,GR00T N1 用 11 小时生成了 78 万条合成轨迹,相当于 6500 小时的人类演示,和真实数据混着训练,性能比只用真实数据高 40%(2025 年 3 月 18 日)。但仿真到真机的路上,摩擦力、阻尼这些参数只要差一点,动作就可能失效。螺纹咬合那一下的手感,仿真里能还原多少,还得拿到真机上验。
数据成了一门生意,但没人想好怎么收钱
既然缺数据,就有人造数据。过去一年多,国内长出了一个新行业:数据采集。
先看规模。新华社 9 月 15 日的报道称,截至 6 月底,全国已建成启用的具身智能训练场超过 70 家,在建和规划中的还有 40 多家,业内叫它们“机器人学校”。另一份研究报告的统计更宽,截至 2026 年 4 月底,使用中或规划建设中的数采中心至少 90 个,其中已投入使用 64 个。嘉兴一座工业具身智能实训中心 2026 年 3 月开始运营,配了 240 台机器人,已经采集了约 1 万小时的工业操作数据。智元在上海浦东的专属工厂有 4000 平方米,单台机器单日的数据产量在千条量级。京东更大:它宣布,用 10 万员工加 50 万社会人员,一共约 60 万人,在两年内积累 1000 万小时的人类真实场景第一视角视频。
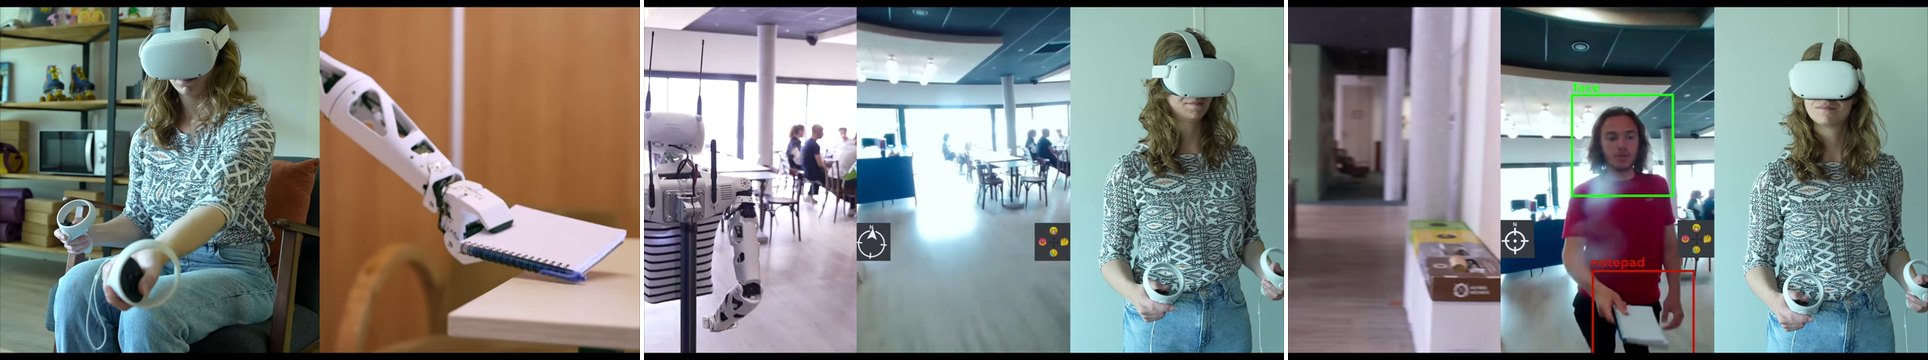
再看采集的几种办法,成本差得很远。真机遥操作,被行业视为数据质量的“黄金标准”,也是最重的资产:一套遥操作设备超过 20 万元,机器人本体 40 万到 70 万元,机器的有效服役寿命大约 2 到 3 年,遥操员一天的有效产出只有 2 到 3 小时。无本体的便携采集,每小时数据的价格在 100 元到 200 元,只有真机的几分之一,但采完之后的处理更麻烦。第一人称穿戴式采集的成本最低,规模化的潜力也最大:一名家庭主妇戴着采集头环,一天能产出三四小时数据;它石智航让产线师傅戴五指智能手套,在真实环境里照常干活,鹿明计划投放 1 万台背包版的 UMI 设备。
几条路放在一起看,大致是这样的:
| 路线 | 每小时数据的市场价 | 设备投入 | 主要限制 |
|---|---|---|---|
| 真机遥操作 | 500 到 1000 元(另有口径 200 到 500 元) | 遥操作设备 20 万元以上,本体 40 万到 70 万元 | 与本体强绑定,换机器人数据基本失效;操作员一天只有 2 到 3 小时有效产出 |
| 无本体便携采集(如 UMI) | 约 100 到 200 元 | 设备便宜,五指智能手套单套超过 1 万元 | 多采集夹爪动作,缺少触觉和力觉,对五指灵巧手的任务支持不够 |
| 第一人称穿戴 | 最低,规模化潜力最大 | 头环、手套这类轻设备 | 需要把人的动作对齐到机器人的控制逻辑,还有隐私合规问题 |
| 仿真合成 | 取决于算力 | GPU 和仿真环境 | 摩擦力、阻尼这类参数偏差,会让迁移到真机的动作失效 |
没有哪一行是全能的。质量最好的最贵,规模最大的最糙,所以才会有厂商转头去找无本体数据做预训练、真机数据做后训练的组合。另外一个常被说起的麻烦是脏数据:有报道举例,一周采下来的数据,大半可能是废数据,多模态信号的时间还对不齐。
一个数采中心满负荷运转,一个月大约能产出一两万小时数据。按 64 个在用的中心粗算,满负荷是每月 64 万到 128 万小时,一个月就能超过全球现有的“高质量真实数据”估算存量。这是理论上限,实际远没有跑满。
产能在涨,钱没有跟上。《具身数据发展报告 2026》的判断是,采集训练场的产能增长,和付费需求的节奏对不上。21 财经 10 月底的一篇报道也说,数据采集的热度从去年上半年持续到今年上半年,下半年有所降温;一位数采中心的人士说,数据量的膨胀,并不等于价值的增长。
为什么?几个原因,报告和采访里都提到了。第一,产品是一次性项目交付,交付以后很难复售,没有标准化的东西可卖。第二,真机数据和机器人的本体强绑定,换一种机器人,数据几乎失效。第三,不同企业对任务拆解、动作阶段和成功失败的判定标准各不相同,数据难以融合,国家层面也还没有针对具身数据的行业标准。第四,免费开源的数据集,对商业采购形成了压制。第五,也是最关键的:谁买?数据的采购方主要有三类,机器人本体厂商、具身大模型厂商和数据商,而头部本体厂商大多自己建采集场,真正向外买的,是少数。
于是出现了一些听起来很聪明、也很脆弱的模式。有行业人士提到,一种做法是“卖机器人,同时承诺回购数据”:厂商卖出机器人,买家顺手帮忙采数据,再按约定价格卖回给厂商。数采中心的从业者评价它“更接近一锤子买卖”,可以让厂商短时间的业绩变好看,但不可持续。另一边,公共服务型的训练场,多由政府或国资主导,以财政资金为主。前面那篇关于减速器的文章里说到,优必选的订单里,据一篇分析文章的估算,约 59% 来自政府数采类项目,这和这个行业的结构是吻合的。
2026 年的变化,是厂商的需求在转向。年初,行业以真机采集为主;到今年 6 月,多家厂商的态度转成“需要的是无本体数据”。无本体数据主要用在预训练阶段,真机数据主要用于针对具体场景的后训练。预训练要量,后训练要准,这两个市场的价格和客户都不一样,可大多数数采公司还是按一个模式在卖。
这里有一个看上去矛盾的局面:整个行业都喊数据不够,数据却不好卖。
编辑部的理解是,最缺数据的人,恰好最不愿意外购。做模型的公司,把数据当成自己的护城河,Generalist 把每周新增的一万小时留在自己手里,头部的机器人厂商多半自建采集场,因为外面买来的数据,换了一台机器就不好用,质量好坏也没法验货。愿意把数据放出来的,是公共机构和开源社区,但免费的东西又反过来压住了商业价格。夹在中间的数据商,卖的是一次性项目,没有复购,能撑起业绩的,常常是政府和国资的财政资金。这种需求,来得快,去得也可能快:一旦财政预算收紧,或者训练场数量过了高峰,产能和付费之间的缺口,就会直接露出来。
所以,别急着把“数据饥渴”理解成“数据公司的黄金时代”。饥渴的是最终要把机器人送进车间的那几家,能赚到钱的,未必是帮他们攒数据的那一批。
回头看那两段画面
回到开头。后空翻,是身体的事:算得准,练得够,就能翻过去。拧螺丝,是数据的事:只能在真机上、真场景里,一遍遍碰出来,而碰出来的这些数据,至今没有人想好怎么才能便宜地攒、体面地卖、通用地用。
编辑部想提醒几个读数,下次看到“某某数据集发布”“某某训练场落成”的新闻,可以对着看:规模是小时还是条数,小时数里有多少是真机、多少是无本体、多少是仿真;数据是不是对外开放,能不能换一种机器人使用;成功率是在公司自己的环境里测的,还是在客户的工位上测的;价格是项目一次性的,还是能按小时复购。这些问题里,答得上来的越多,这笔数据越像资产;答不上来的,多半还是演示的一部分。
一个十步的装配流程,每步 90%,整串只剩 35%。要让这个数字变成 90% 以上,缺的不是更多的后空翻。
声明:本文数据均来自公开资料,仅供行业参考,不构成任何投资、医疗或其他专业建议。如发现事实或版权问题,请联系 wendianshuzi@163.com。